HearSight 是一个音视频内容智能分析工具。通过集成先进的语音识别、自然语言处理和大语言模型技术,HearSight 能够自动将视频和音频转化为结构化的文本内容,并在此基础上进行多维度的智能分析和问答交互。无论您是进行学术研究、内容创作还是知识管理,HearSight 都能帮助您深度挖掘音视频内容的价值。
项目地址:https://github.com/li-xiu-qi/HearSight
HearSight 采用本地优先的单体全栈架构。Web 层是 Next.js 全栈应用(TypeScript 前后端同仓,API 路由即后端),数据落在本地 SQLite,任务进度通过服务端事件推送,不依赖消息队列与外部缓存;AI 能力拆为三个可替换的本地服务:语音识别(本地模型,输出句级毫秒时间戳与说话人分离)、向量检索(本地 Embedding 服务加 SQLite 向量表)、大语言模型(OpenAI 兼容协议,默认指向本机推理服务,改三个环境变量即可切换外部 API)。媒体处理(抽音轨、抽关键帧、链接下载)由服务端直接调用本地 ffmpeg 与 yt-dlp。
问答支持两种模式:默认单轮检索(检索相关片段后一次性生成,答案带可点击的毫秒时间戳引用);Agent 模式由独立 agent 引擎子进程驱动,通过 MCP 协议调用本项目的四个领域工具(检索转写、片段精读、全文大纲、转写列表),并遵循自动注入的领域协议技能(引用时间戳硬格式、检索工作流),可多轮自主检索后再作答,前端实时展示检索步骤。引擎不可用时自动回落单轮模式。
一台带 NVIDIA GPU 的 Linux 机器即可跑通全链路;也可以只起 Web 层,把 AI 服务指向别处。
控制台布局:最左侧常驻活动条(侧栏收起/展开 + 素材库/任务切换),中部三栏为素材库、播放器、文稿面板(字幕/文稿/总结/问答四个页签,面板可收起让位给播放器),栏目宽度可拖拽并记忆。
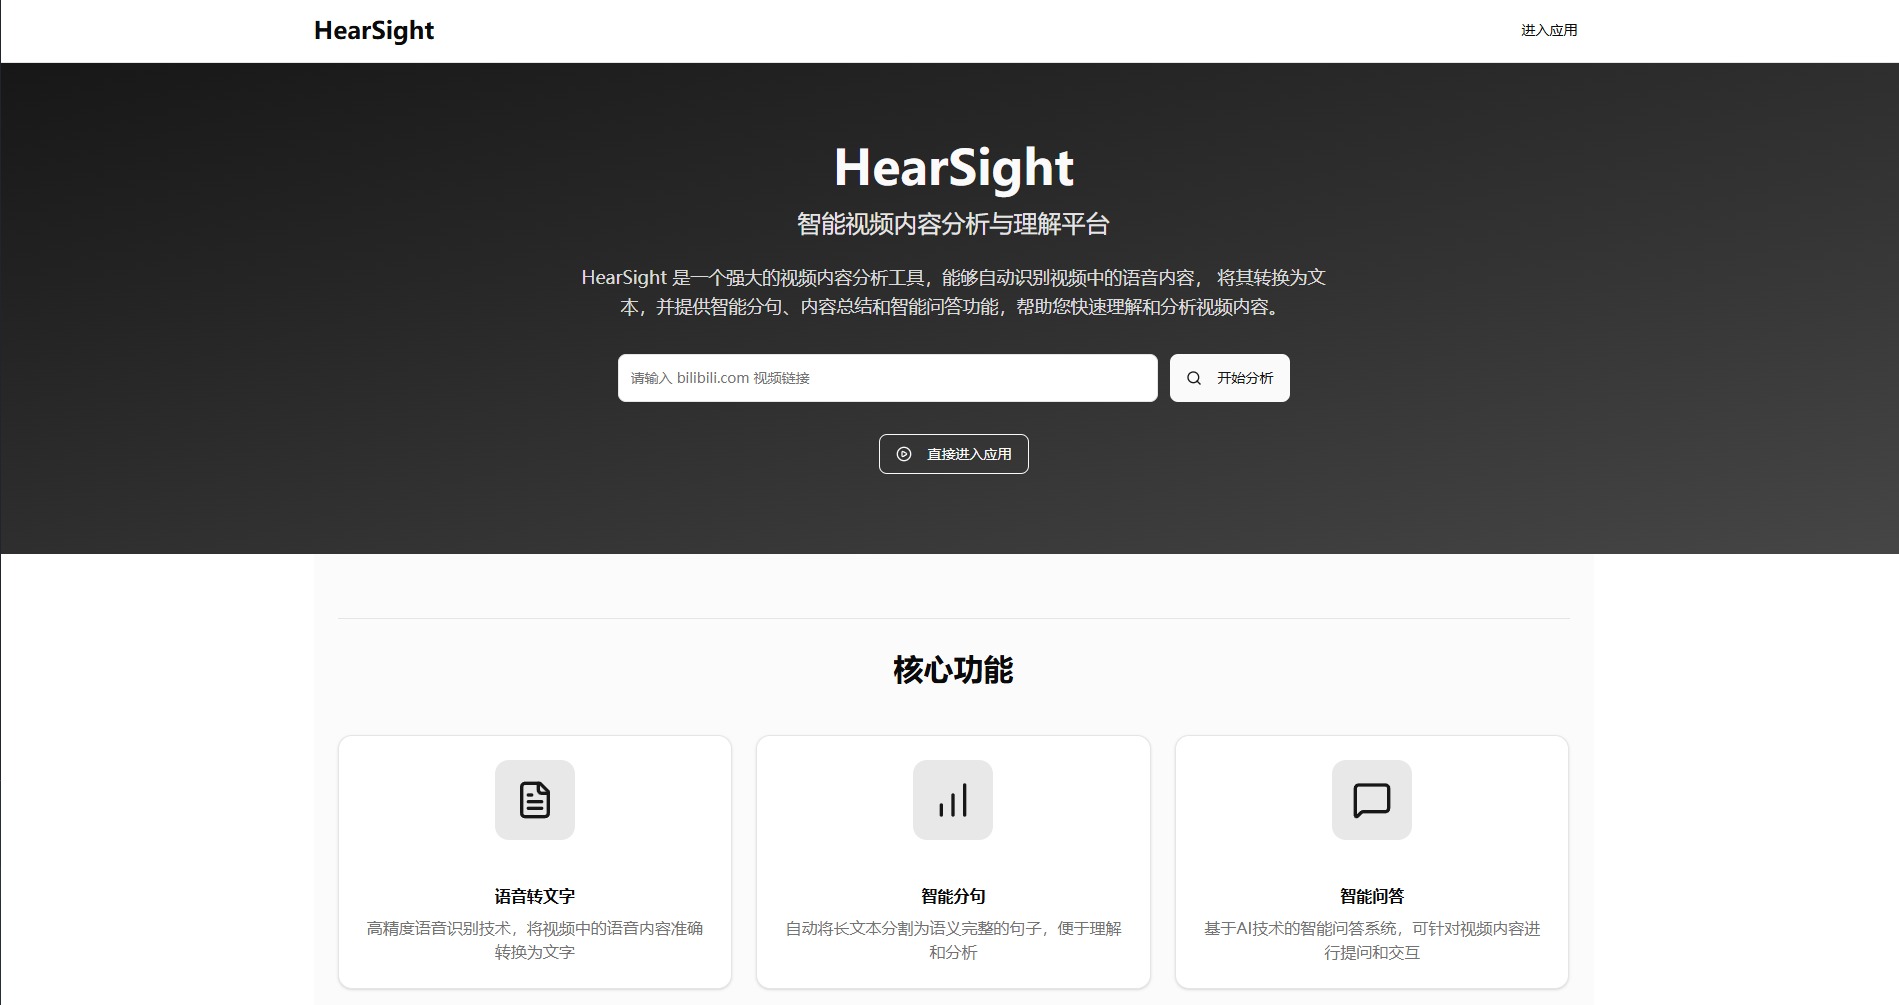
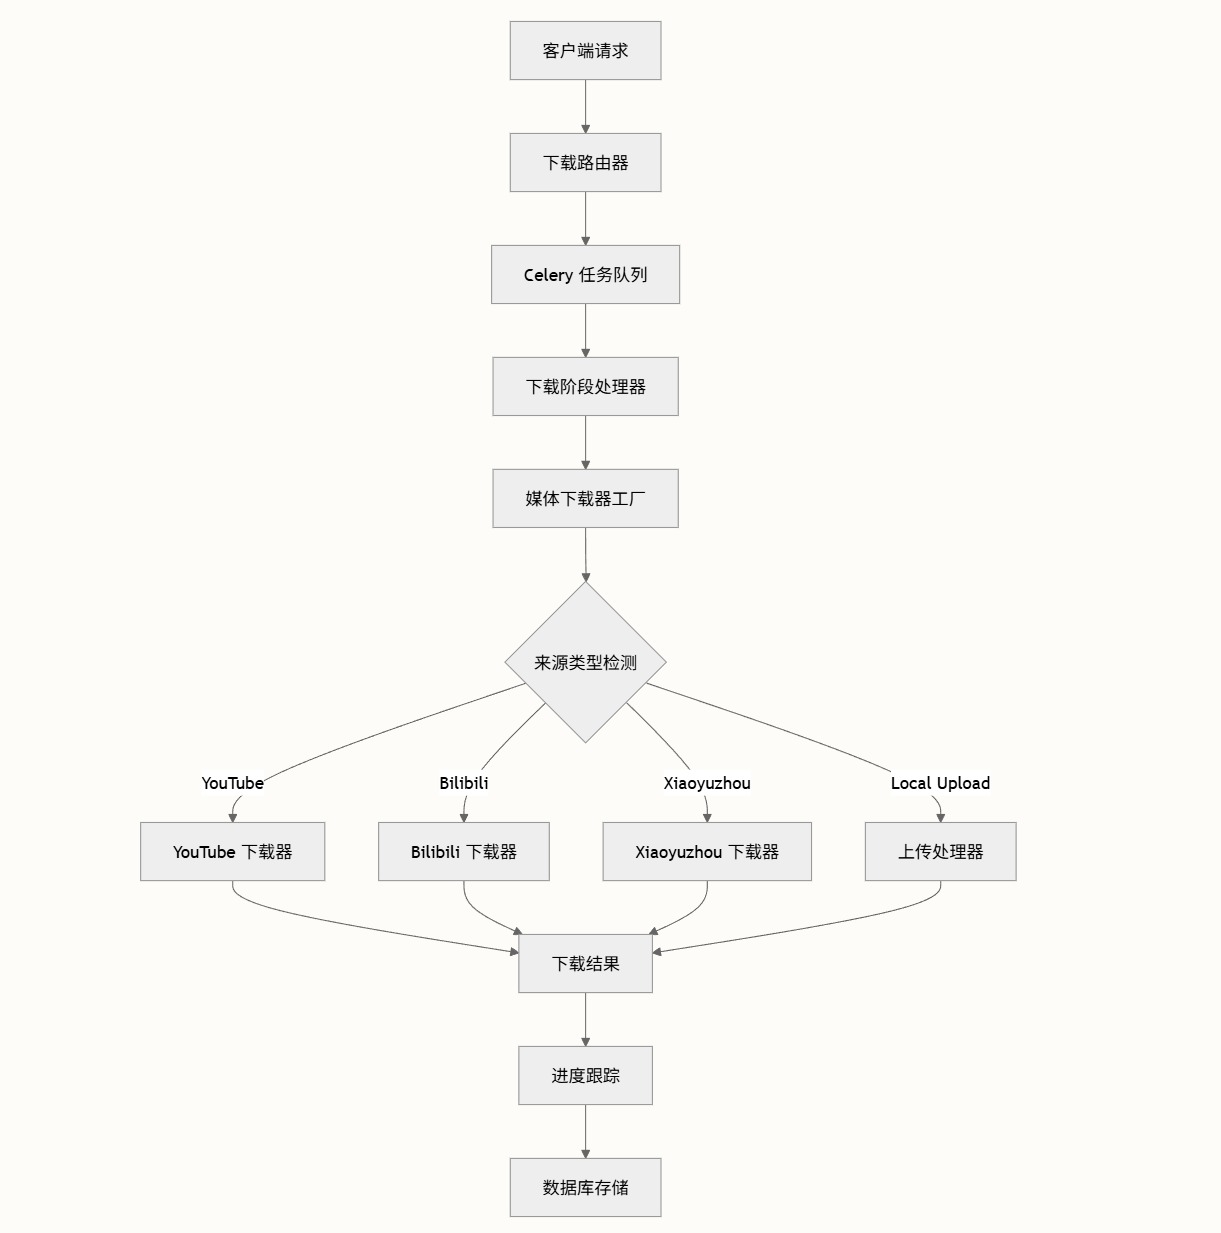
- 📹 集成式媒体导入:直接从哔哩哔哩获取内容,同时支持本地上传视频和音频文件,支持 MP4、AVI、MOV、MKV、MP3、WAV、M4A、AAC 等多种格式
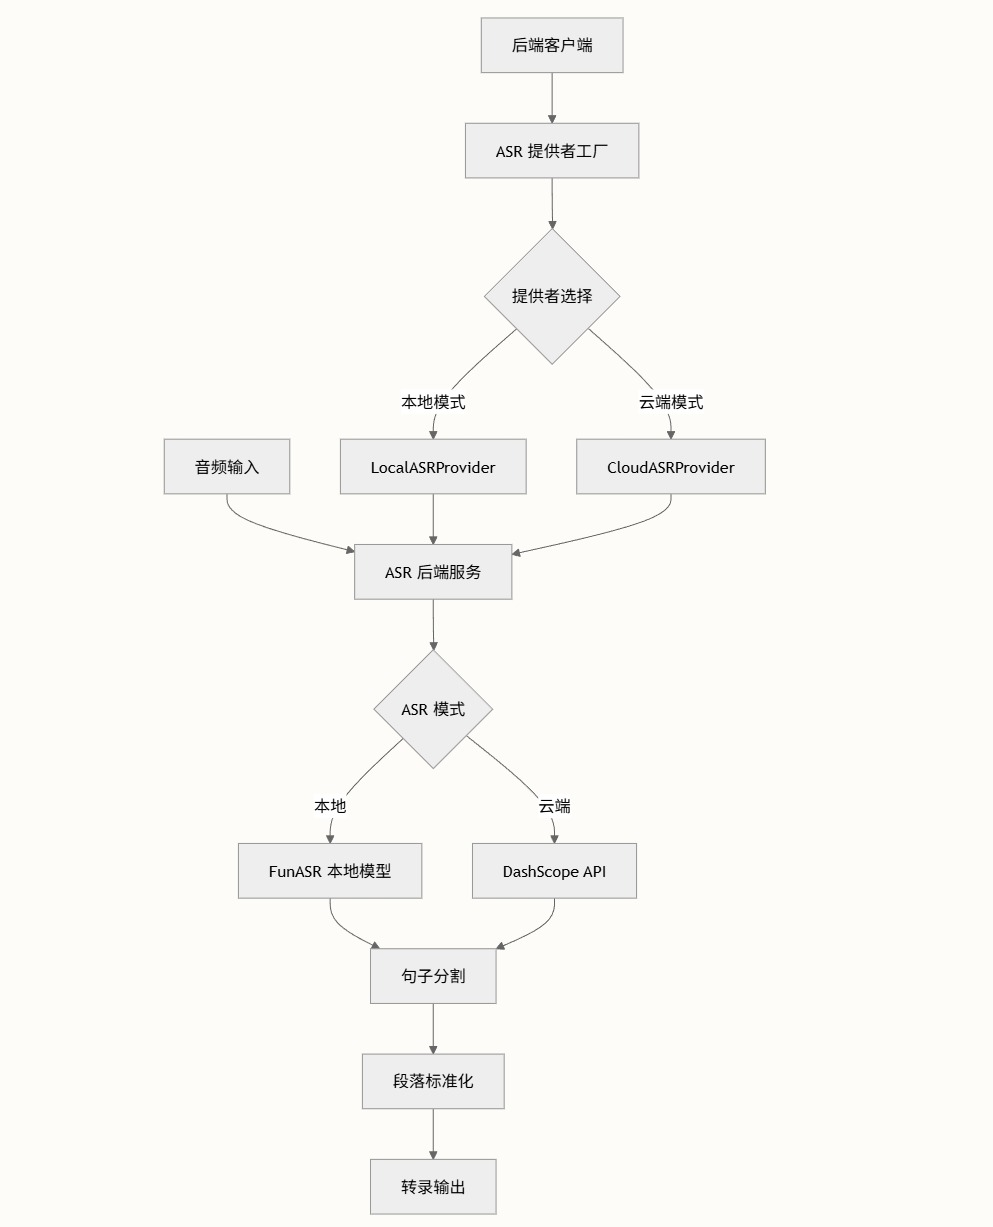
- 🎯 精准语音转写:采用业界领先的 ASR 技术,支持热词识别和实时精确时间戳,自动分句并生成可交互式的文本档案
- 🧠 智能内容分析:基于大语言模型生成段落级和全文级的结构化摘要,支持持久化保存和迭代优化
- 💬 对话式内容理解:支持基于原文的深度问答交互,准确把握关键信息和核心观点,支持单视频和多视频的综合问答与对比分析;Agent 模式下由引擎自主多轮检索转写稿,检索过程实时可见
- 🖼️ 多模态信息展示:在问答和总结中融入视频关键帧,实现图文融合的高效表达(仅适用于视频内容)
- 🌐 多语言内容转换:支持自动翻译为多种语言,翻译结果完整保存,便于国际化场景使用
以下截图来自 2026-09 架构改造前的界面(微服务版)。当前界面已重设计为上述活动条 + 三栏工作台,新截图待补。
视频播放页展示:
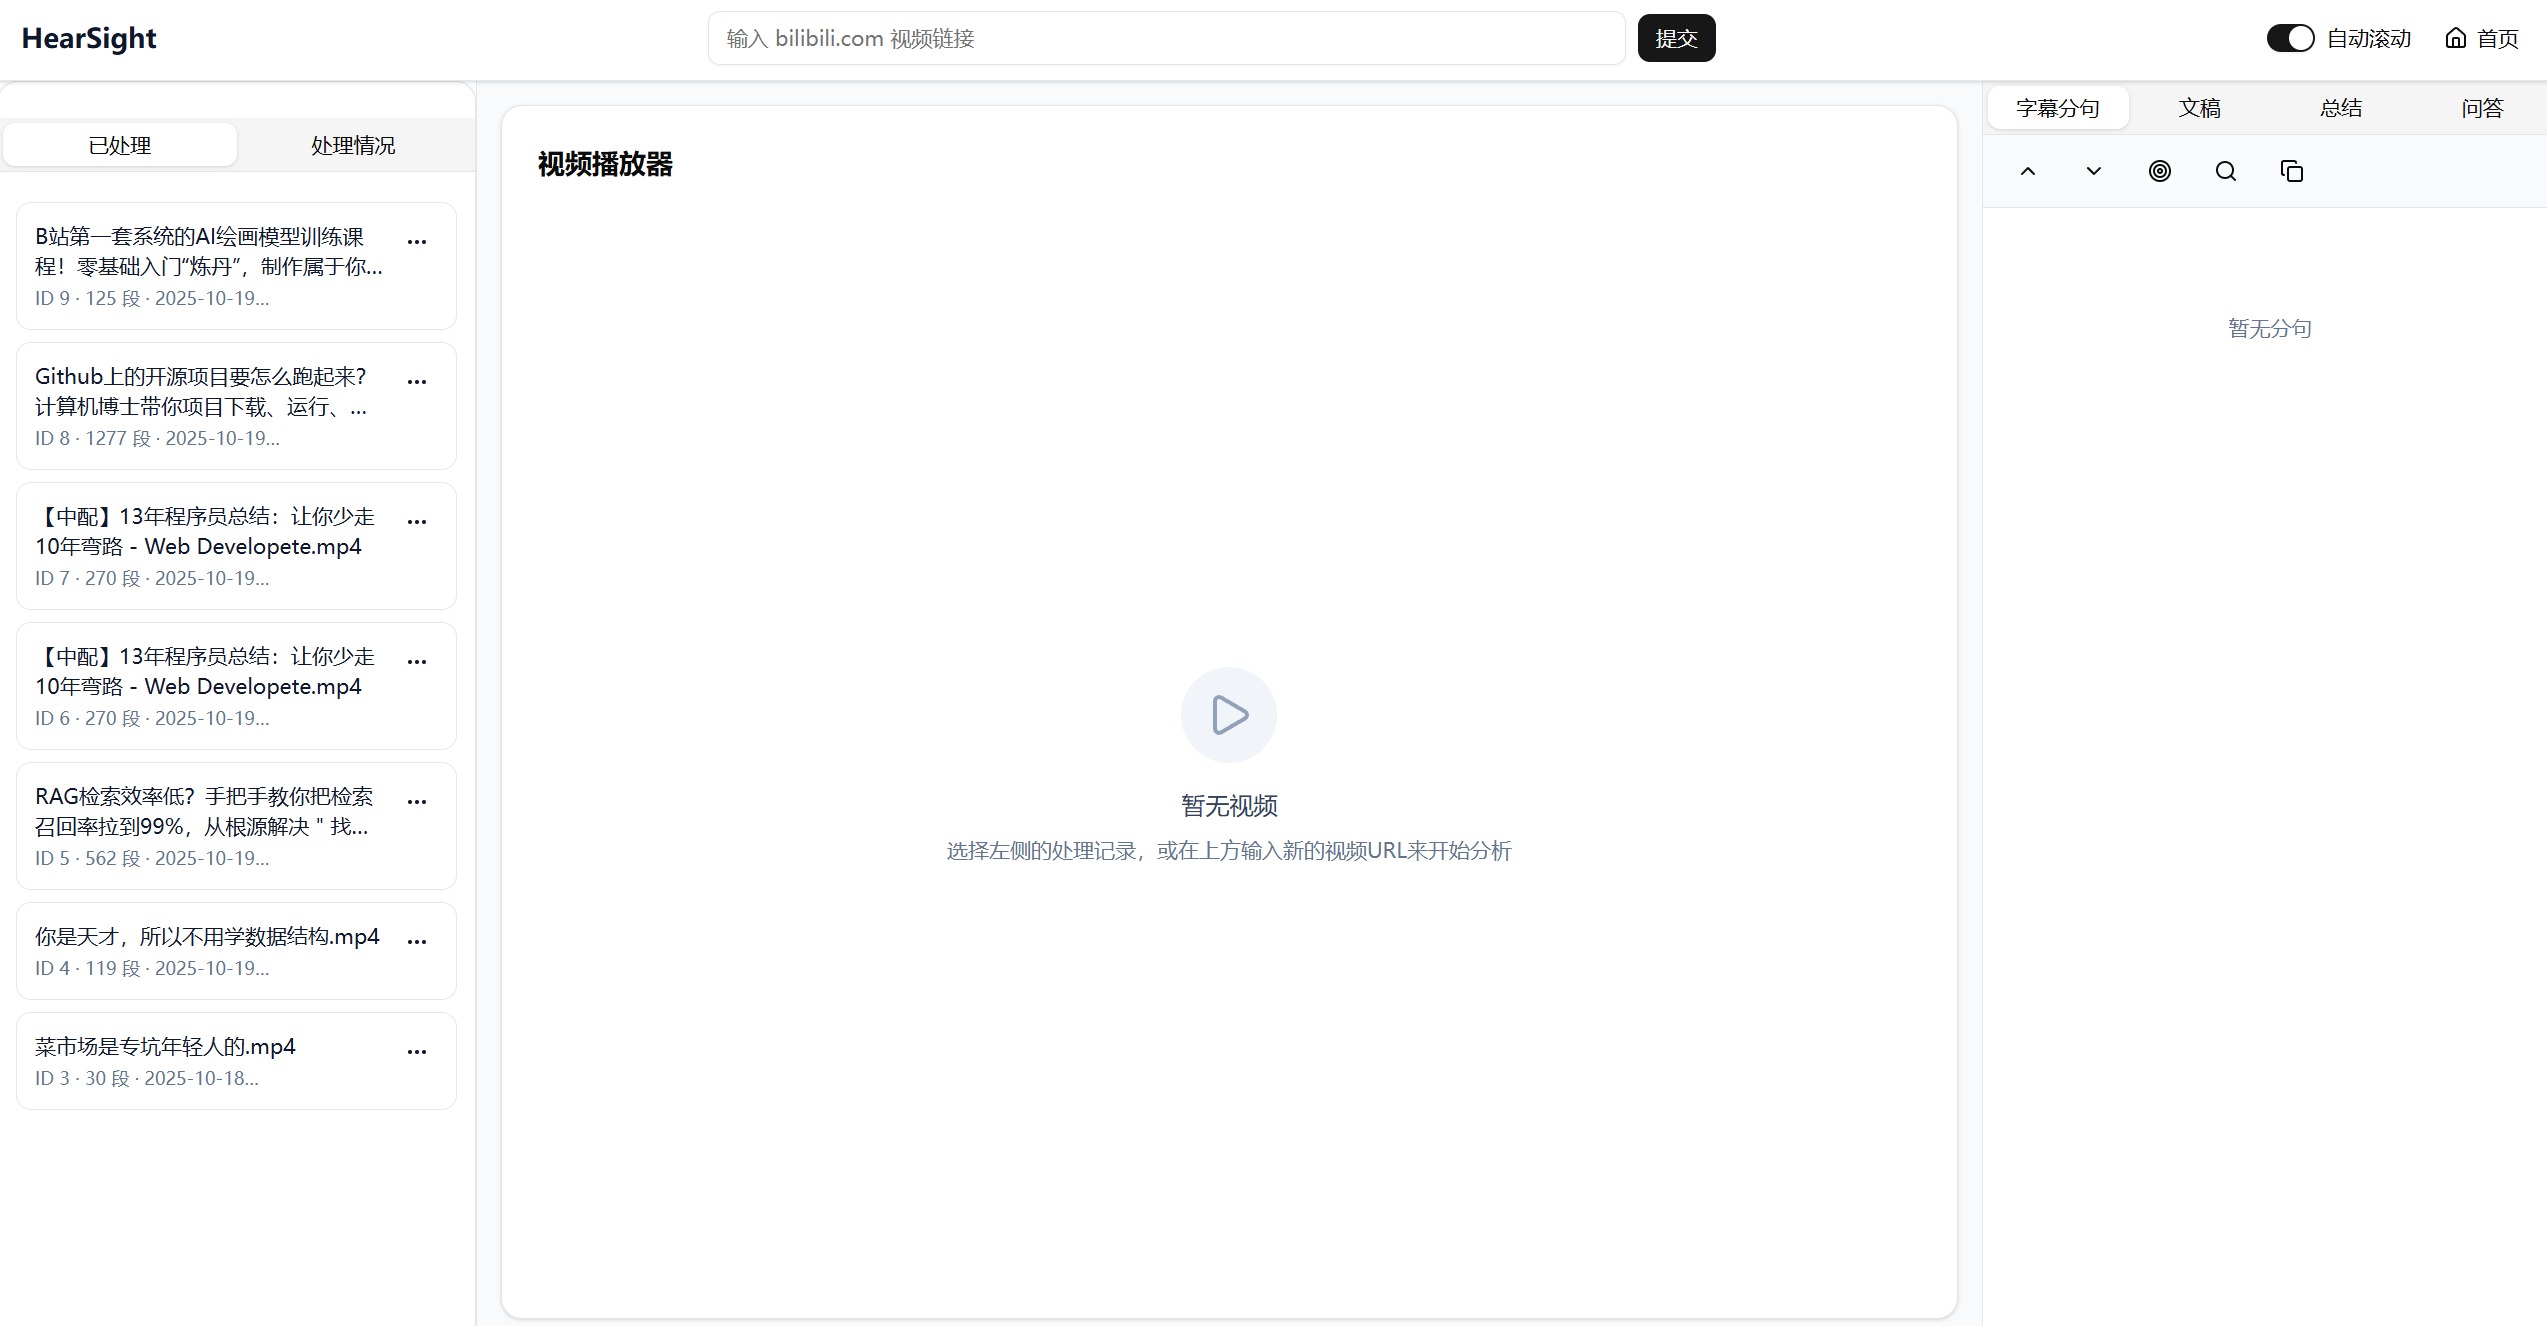
打开一个视频:
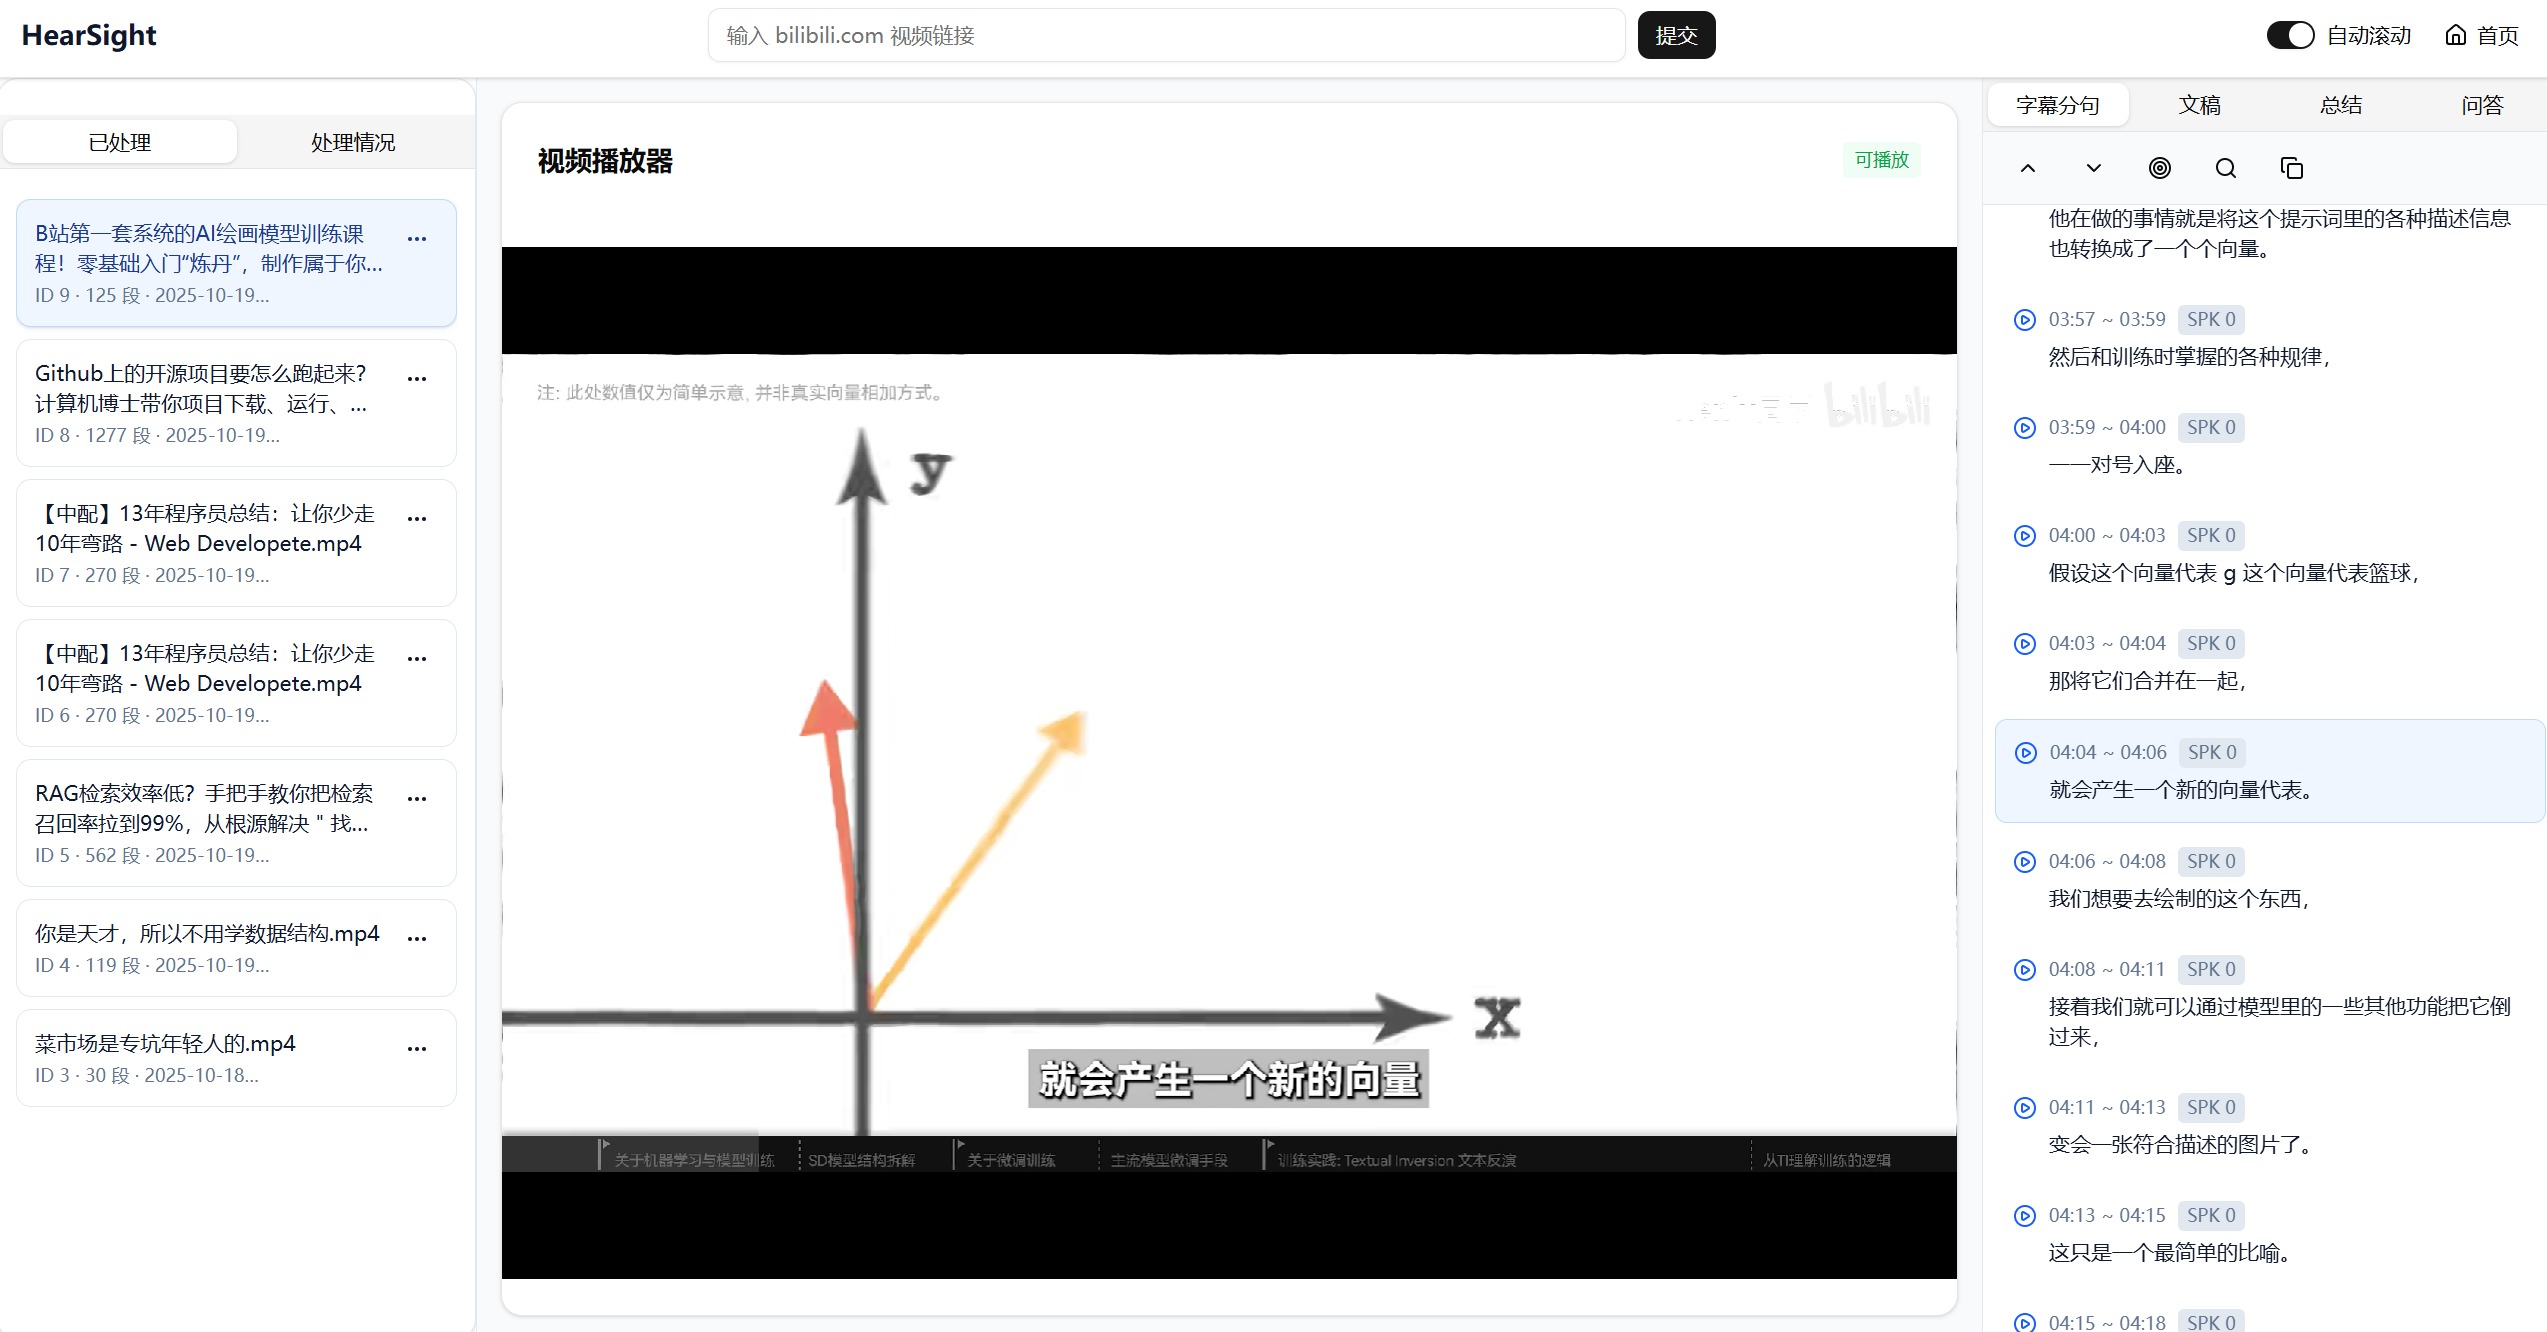
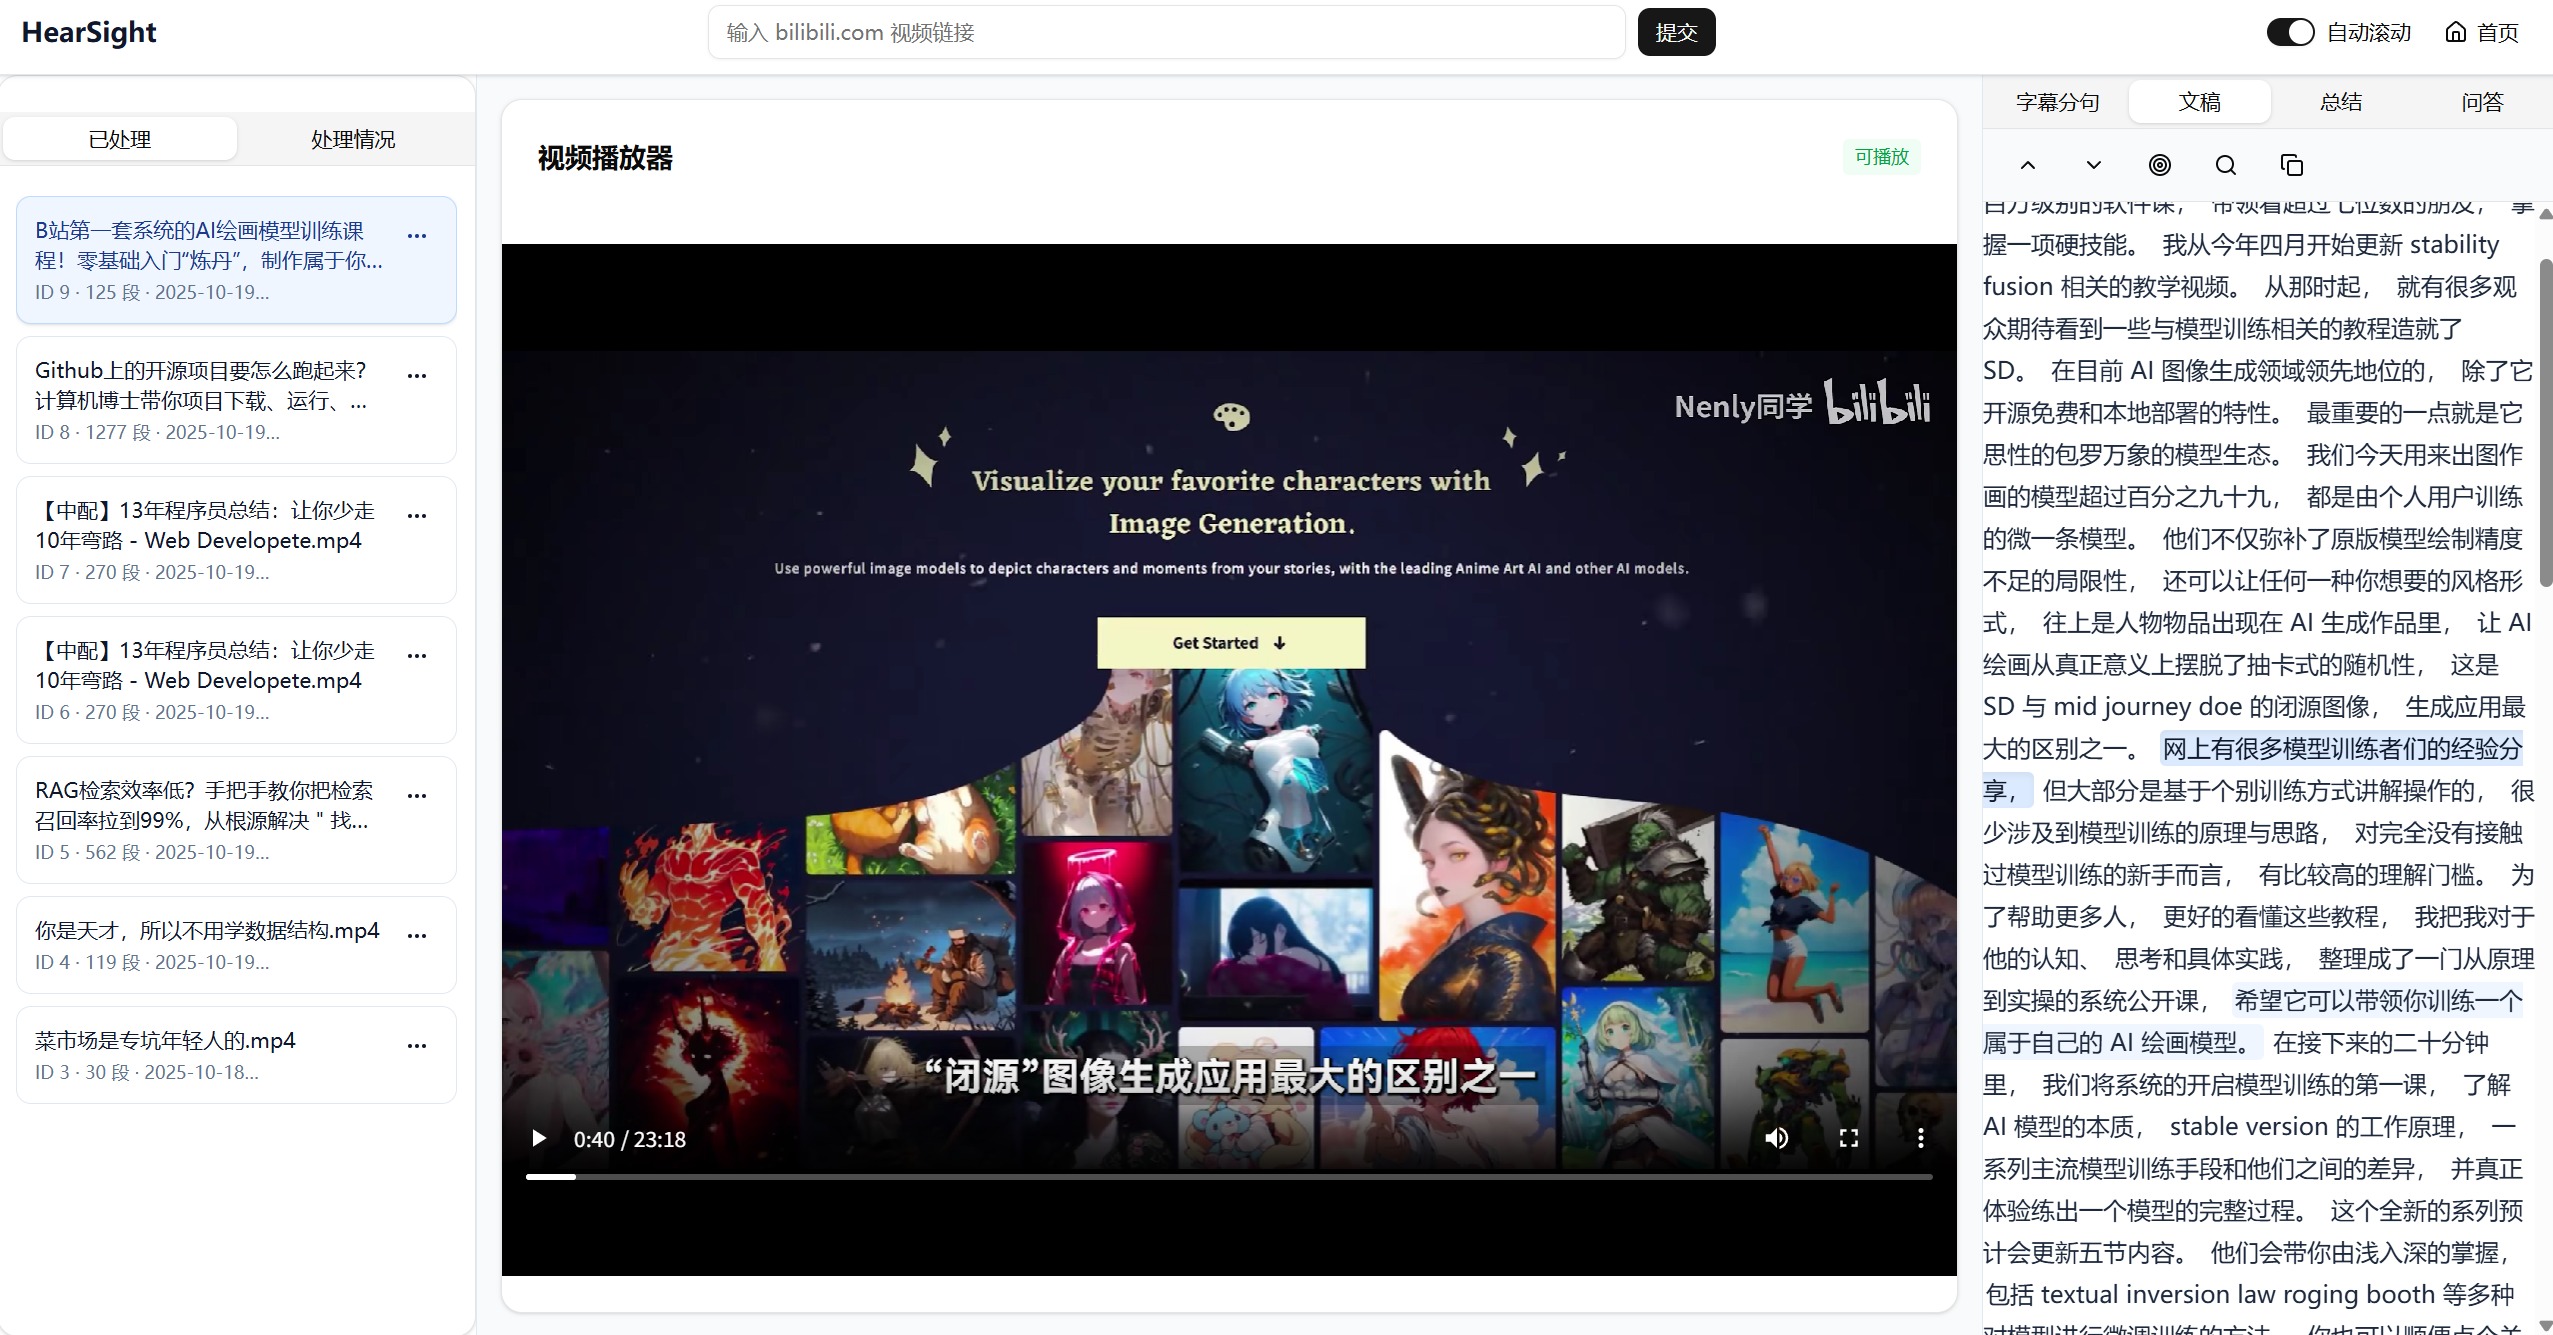
打开视频后的文稿效果展示:
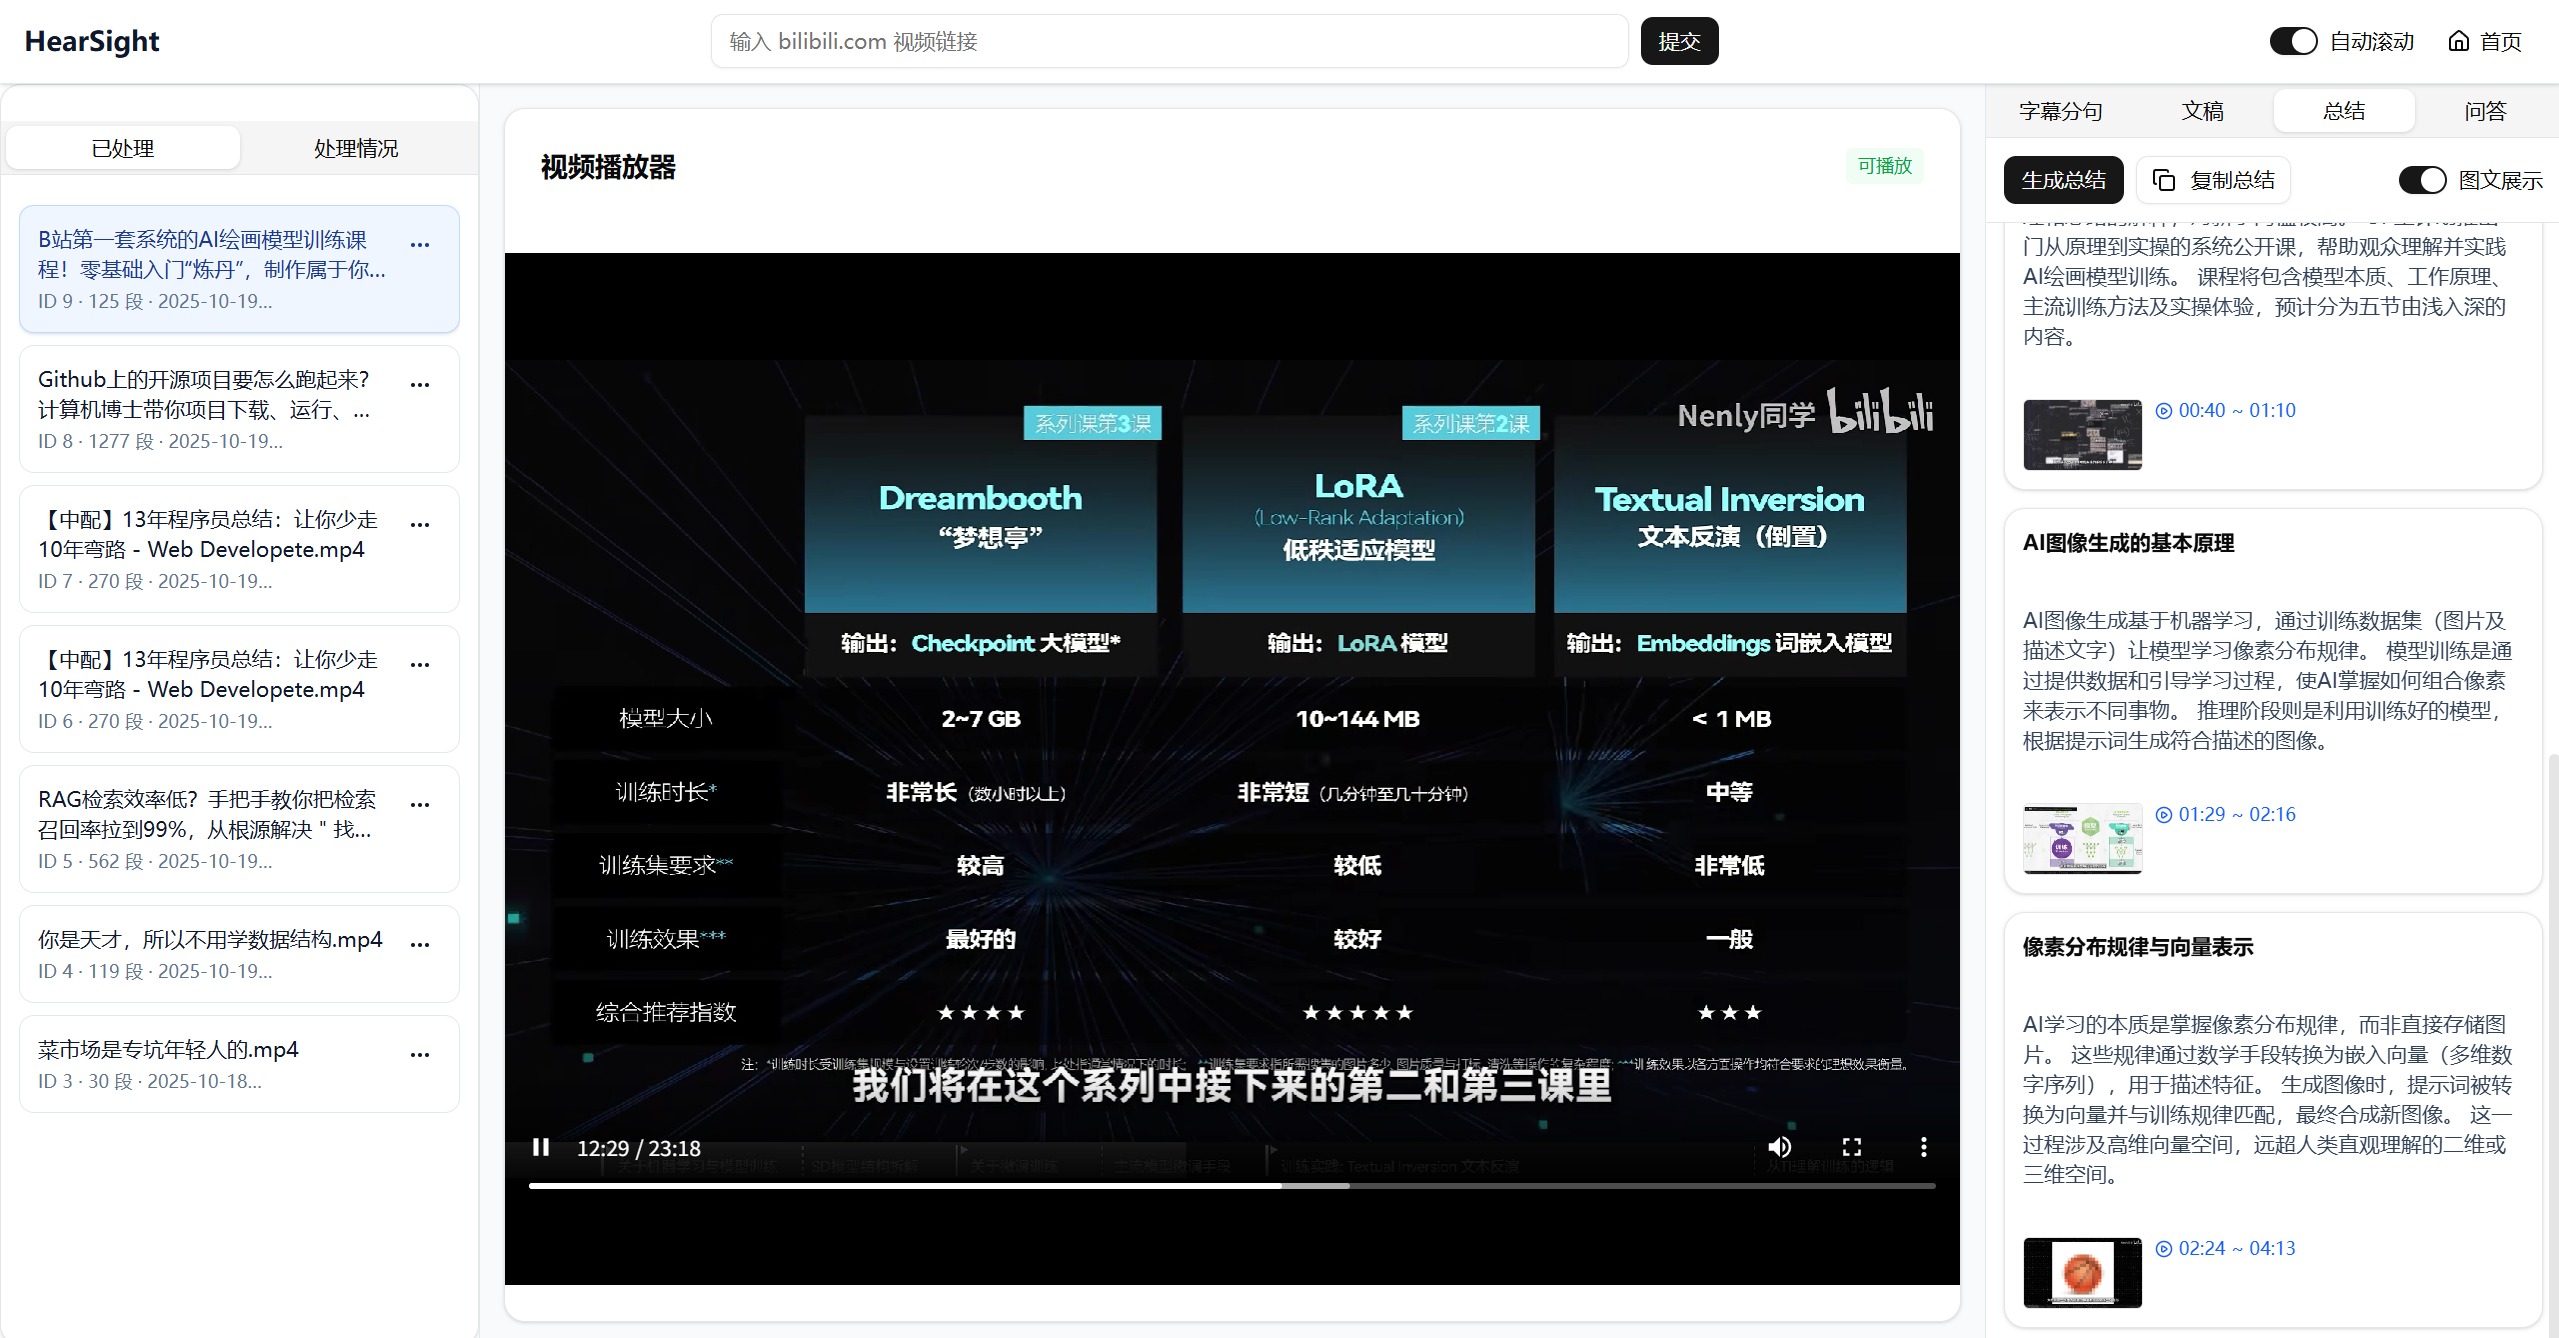
视频总结的展示:
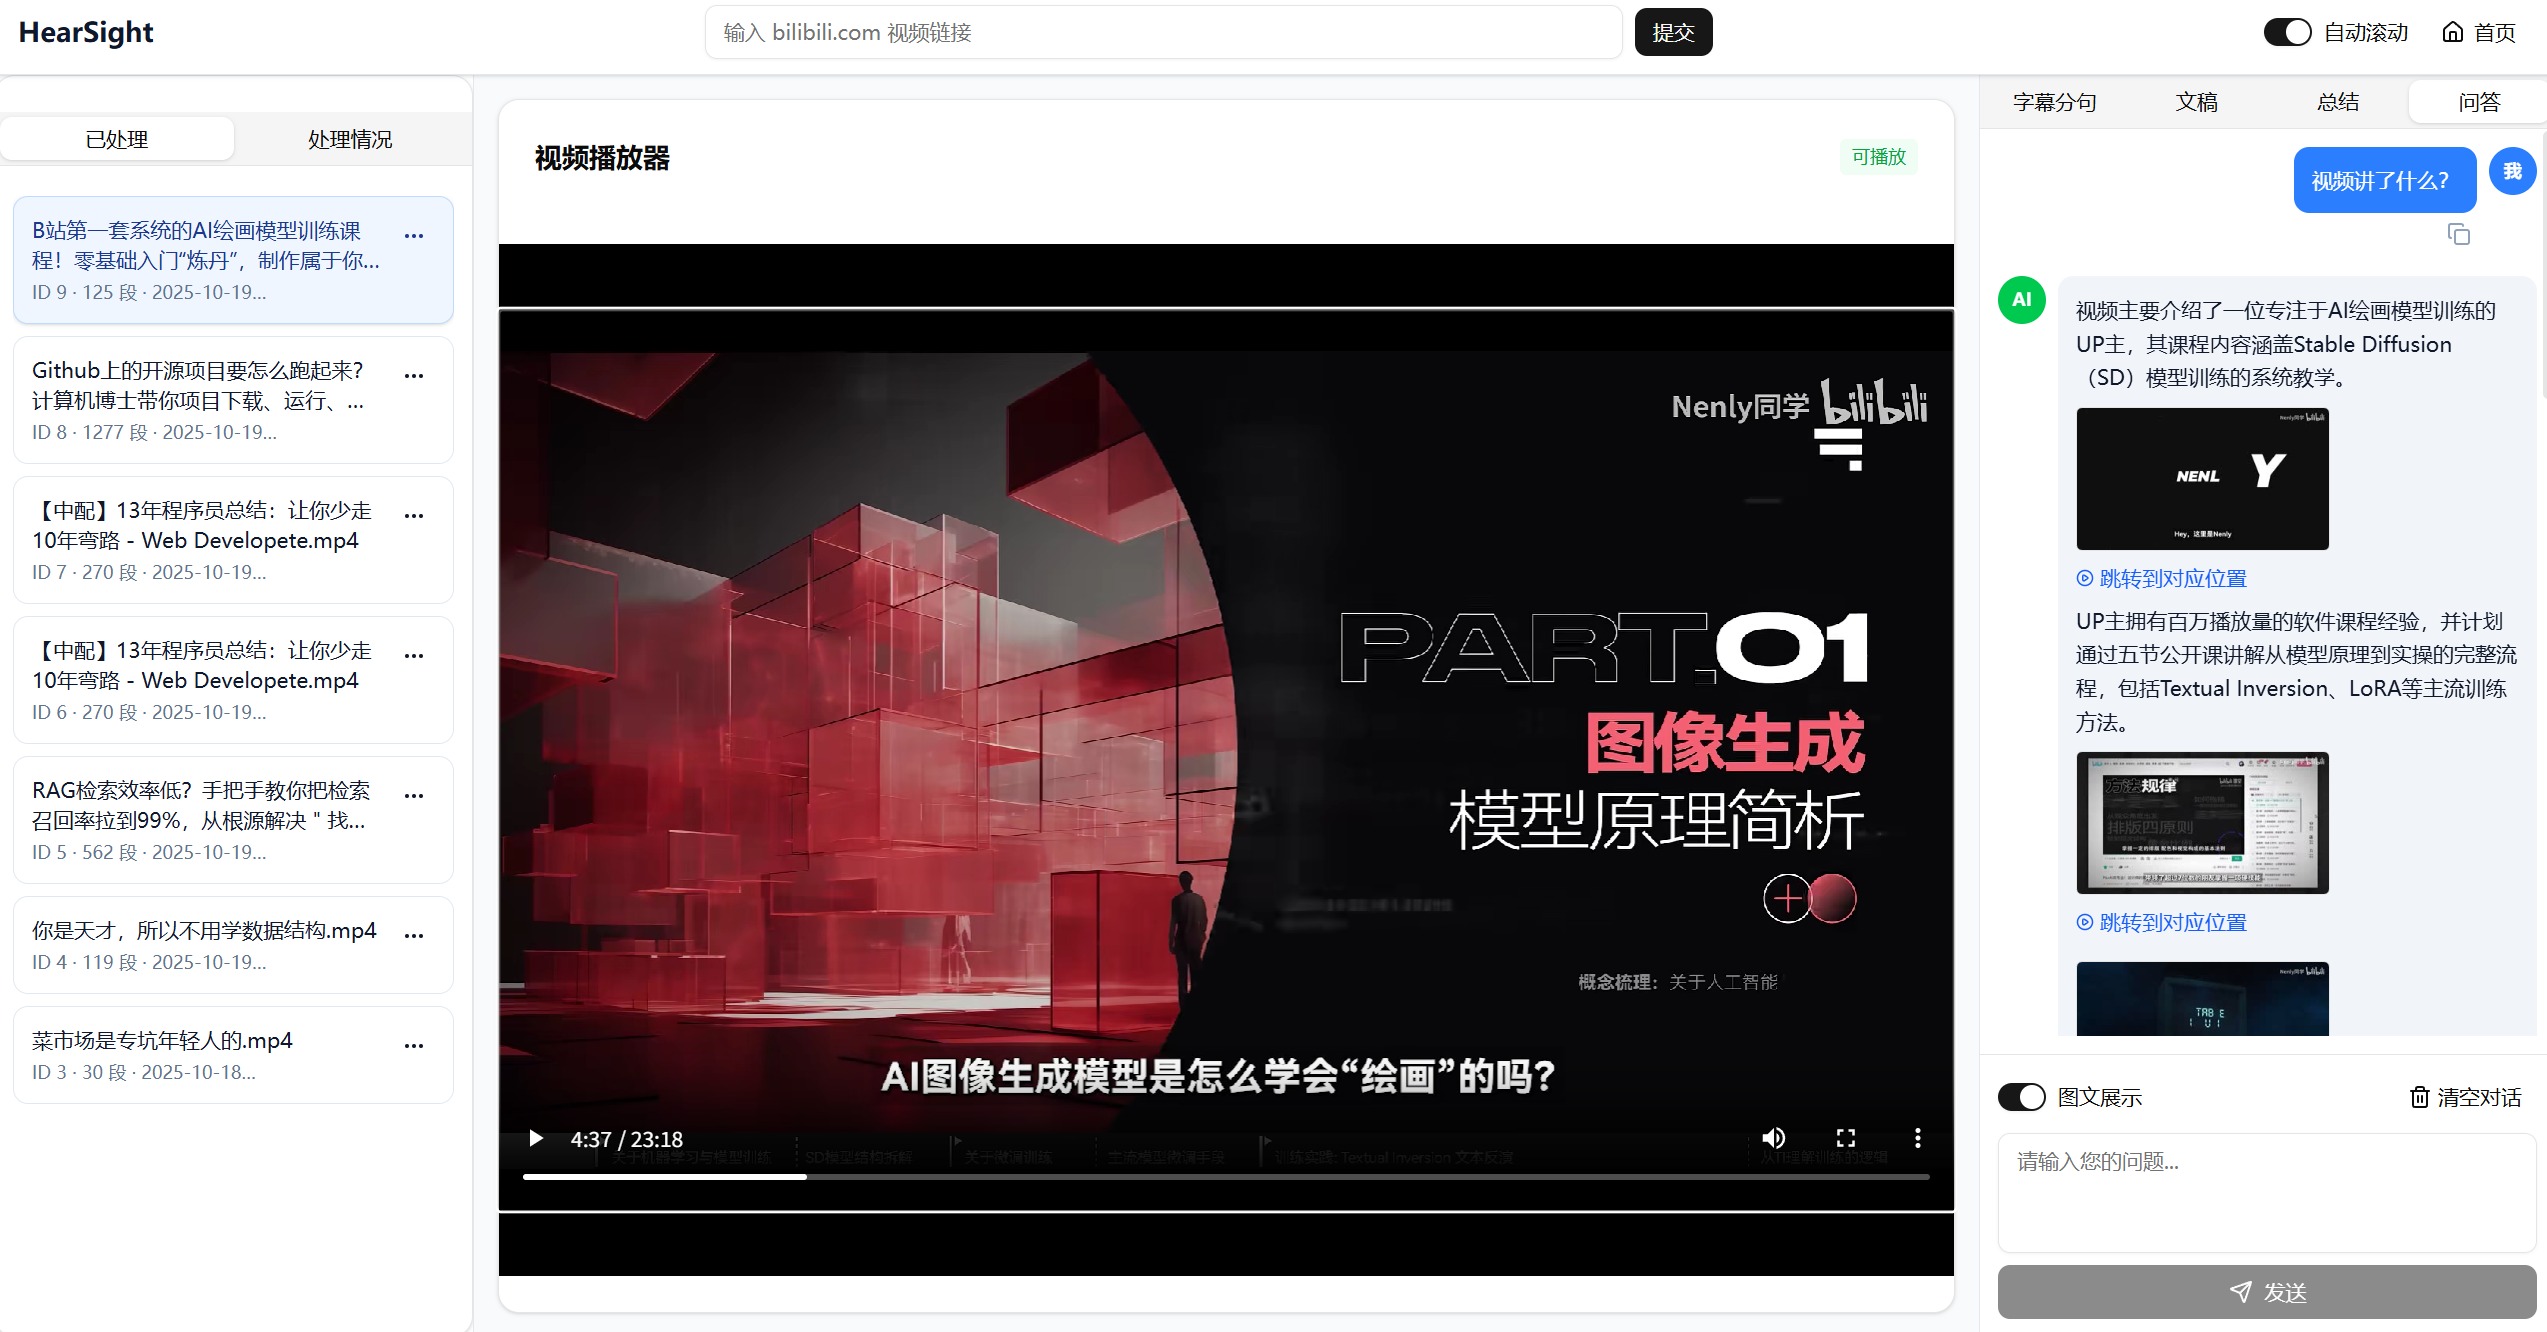
与视频之间的智能对话:
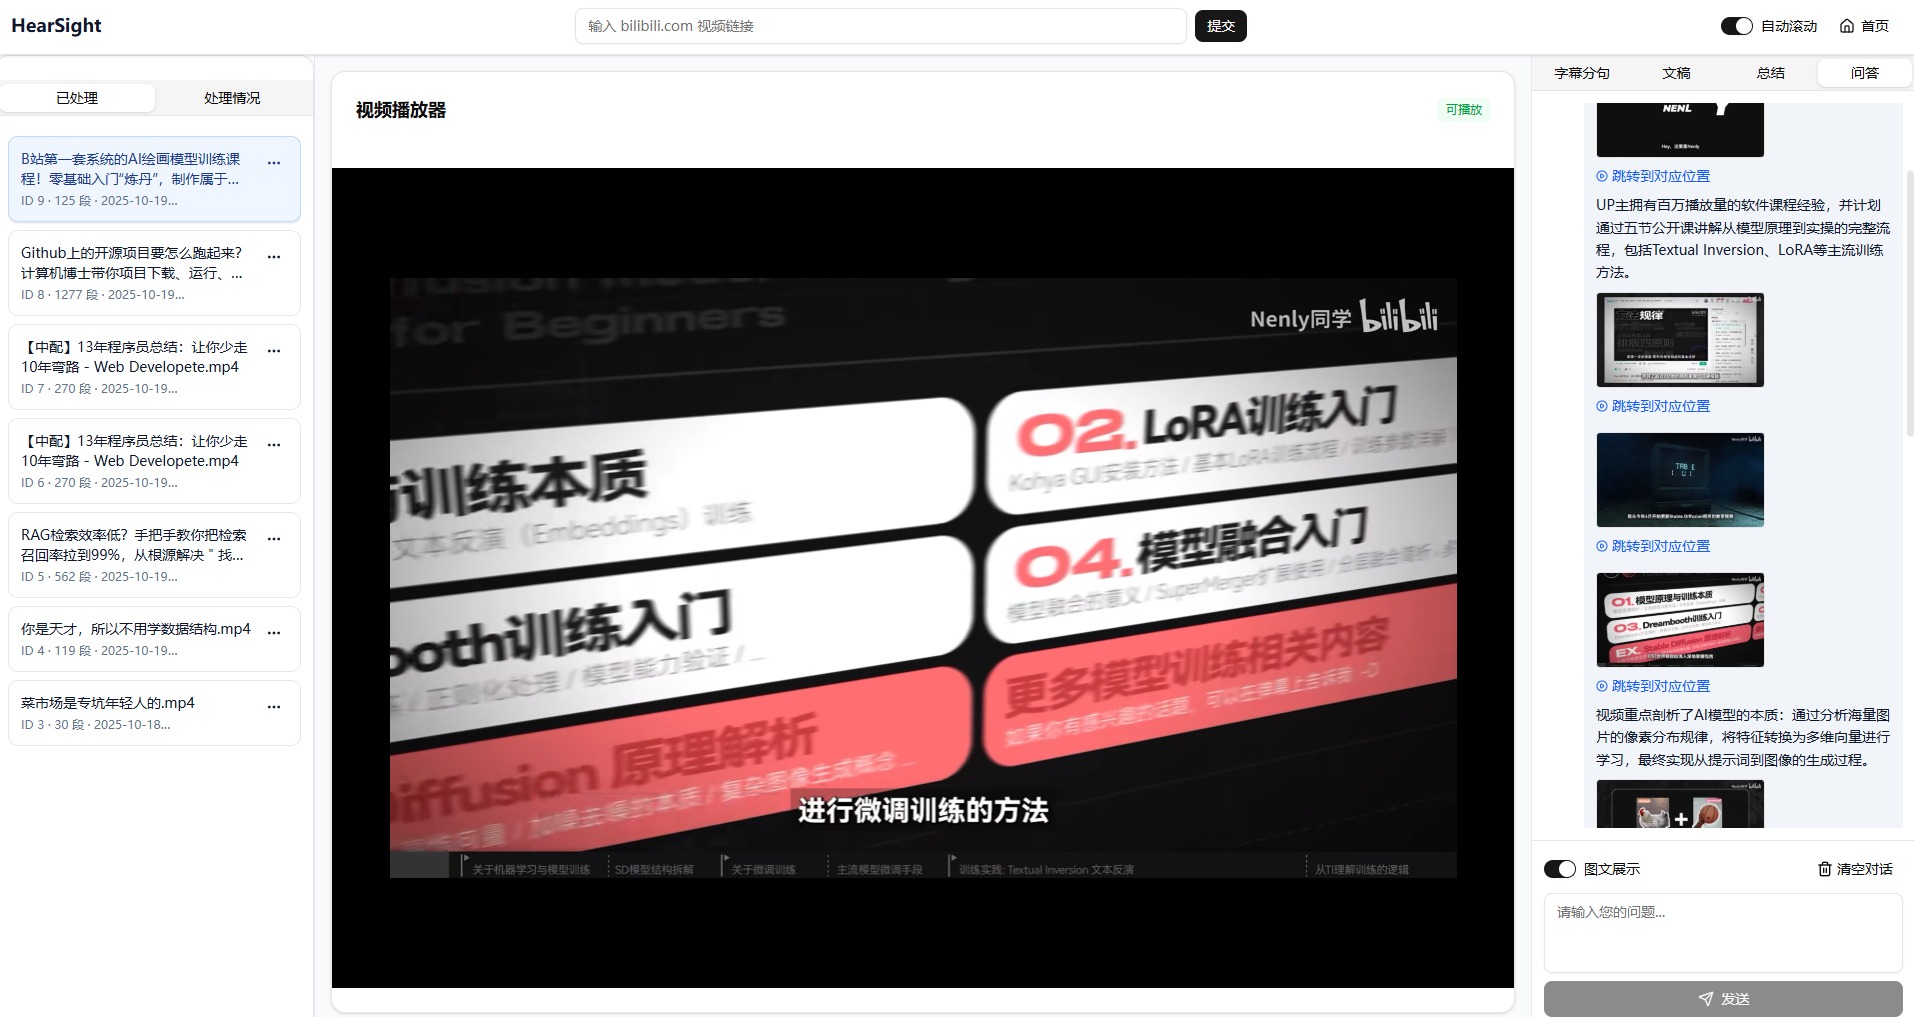
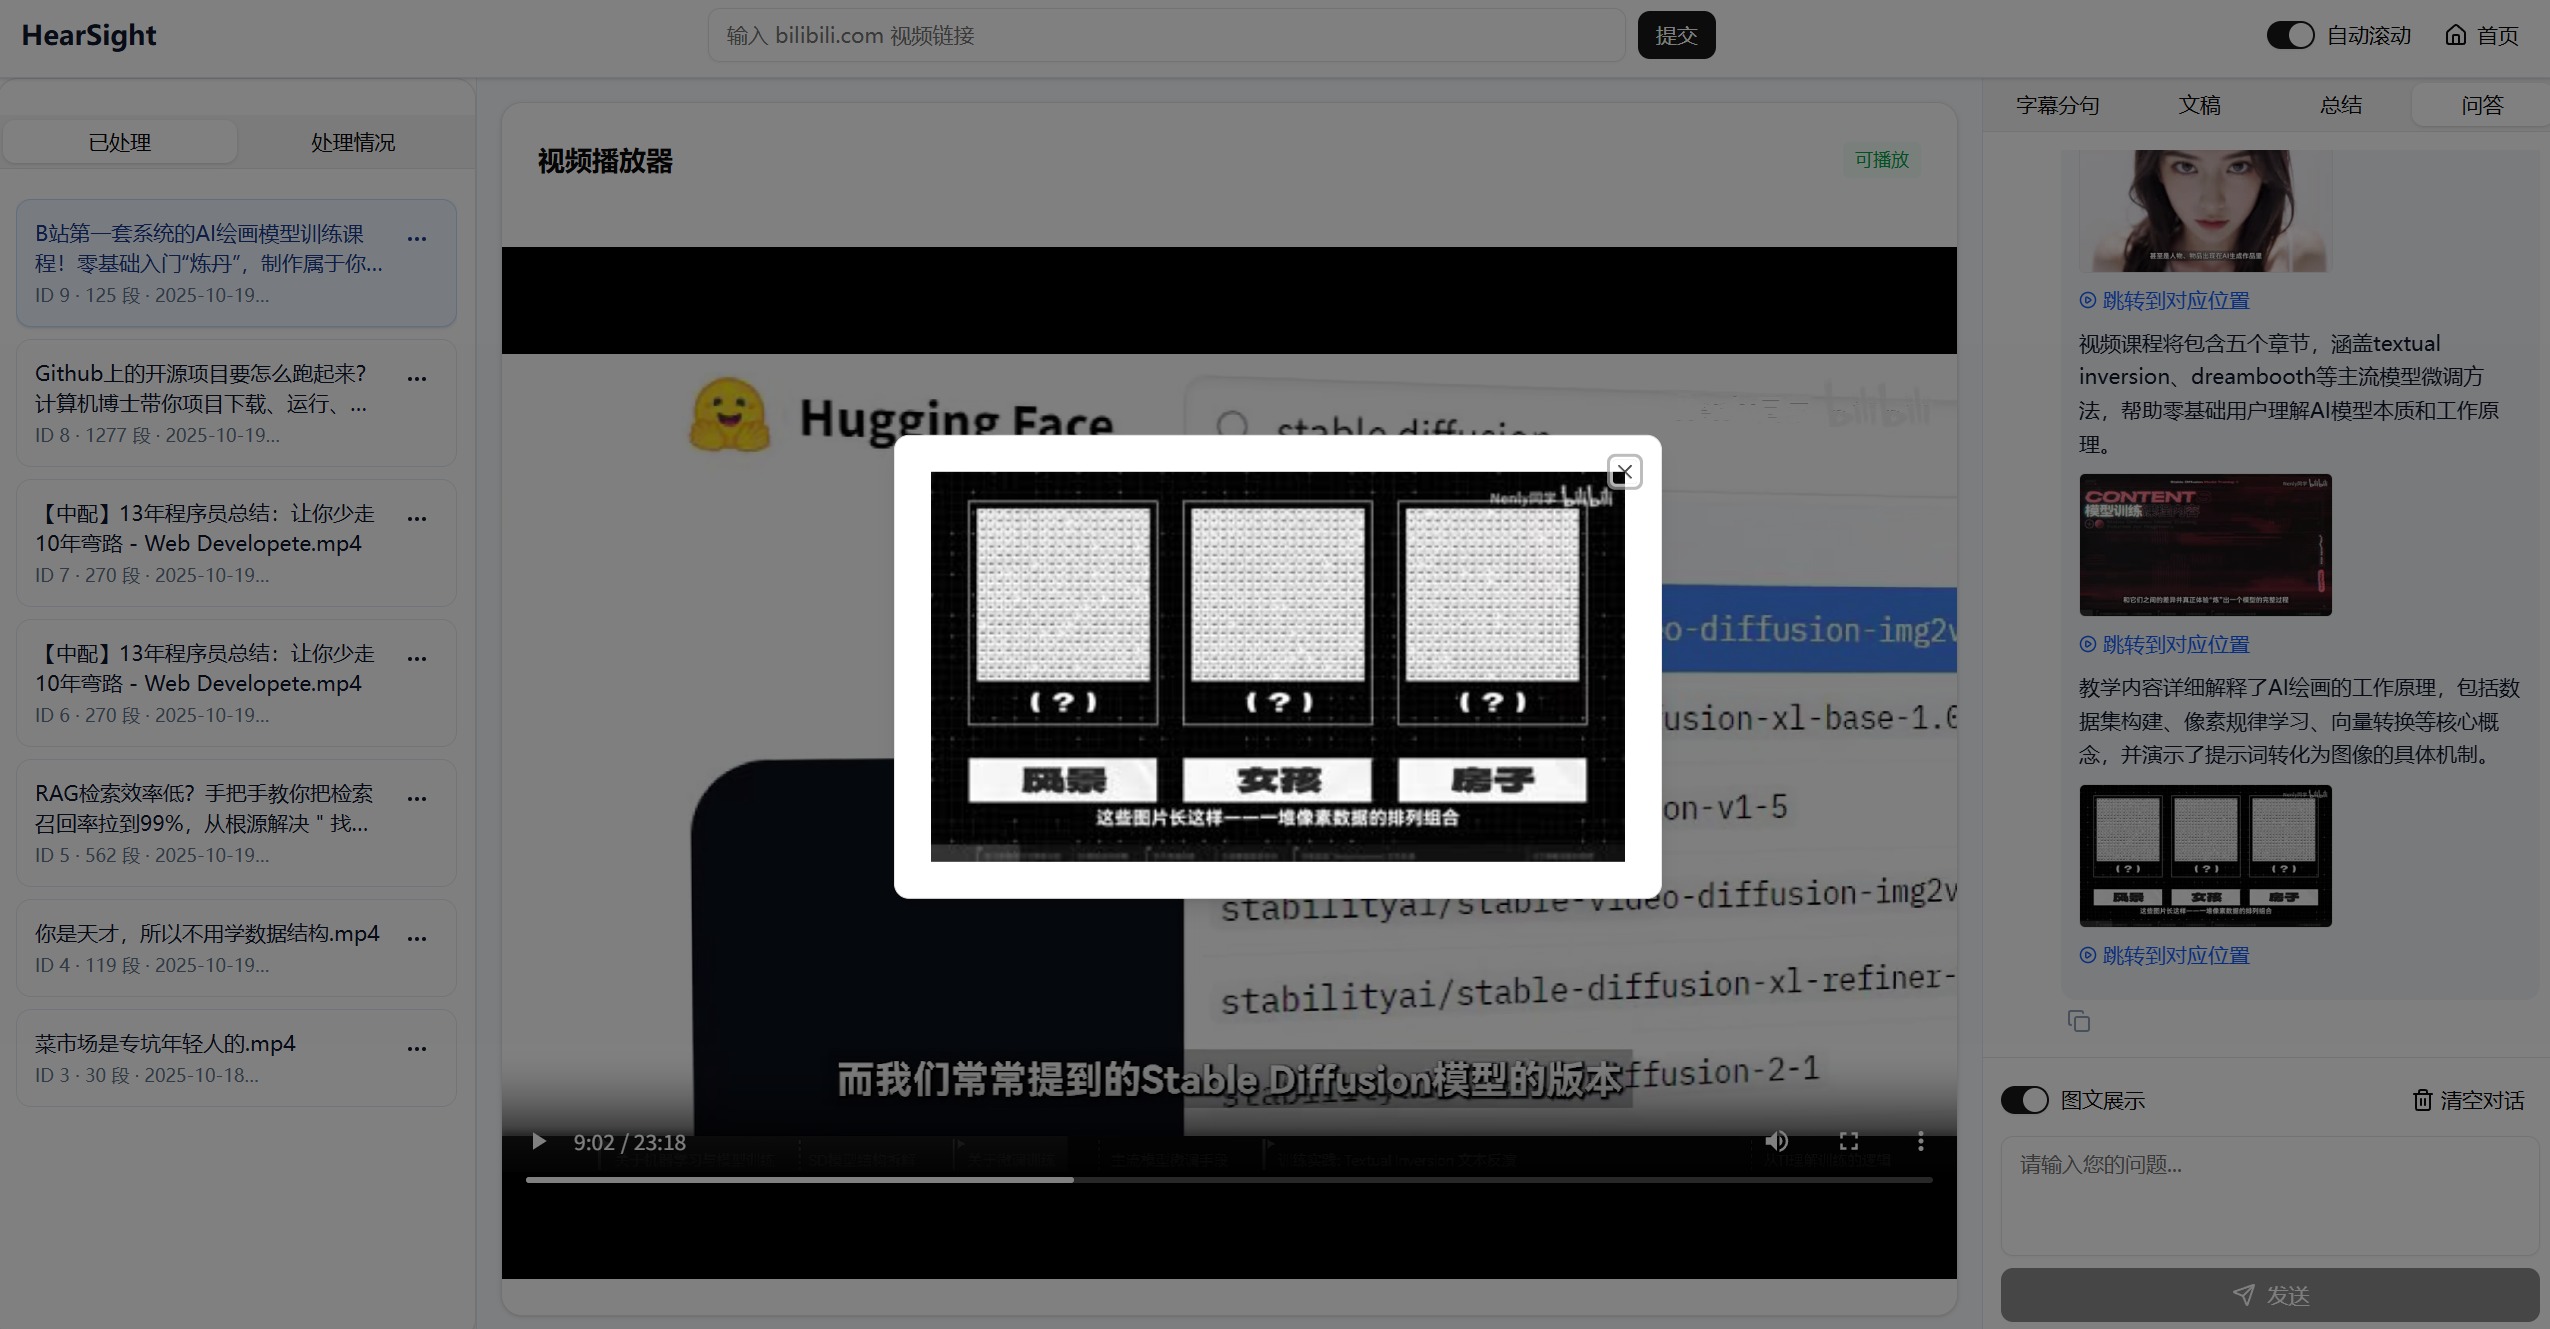
详细的项目结构说明请参考 项目结构。
API 接口文档请参考 API 文档导航。
本地模式要求:Node.js 20+、Python 3.10+、ffmpeg、yt-dlp,以及带 NVIDIA GPU 的 Linux 机器(语音识别、向量、推理三个服务都跑在本地)。
# 1. 安装依赖并构建(--include=dev 不能省,否则跳过类型检查)
cd next-app && npm install --include=dev && npm run build && cd ..

# 2. 按需准备环境变量(缺省全部指向本机回环,零配置可跑)
cp next-app/.env.production.example next-app/.env.production

# 3. 启动 Web 层(默认端口 9187;三个 AI 服务需另行启动)
bash scripts/start-local.sh
环境变量逐项说明见 next-app/.env.production.example。
学术研究:快速整理讲座音频或视频,建立参考文献档案库。教育培训:自动生成教学讲义和习题解析。内容创作:批量处理视频脚本和文案素材。企业培训:构建结构化的内部知识库与学习平台。客户服务:分析客服录音提取关键问题与解决方案。市场研究:监测竞品视频内容并自动生成分析报告。
集成哔哩哔哩接口可直接获取视频(含登录内容),同时支持本地上传多种格式的音视频文件。系统自动处理文件管理和元数据存储,用户无需手动处理繁琐的文件操作。
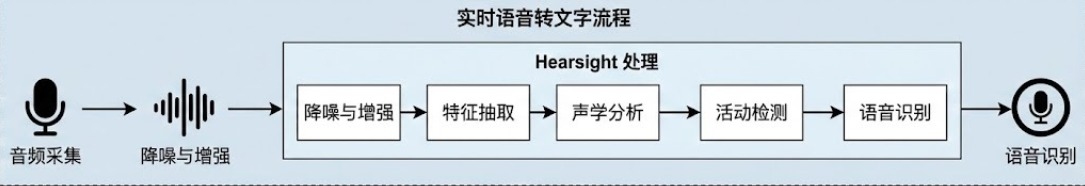
采用行业前沿的 ASR 模型,支持热词识别优化垂直领域准确度。系统自动按句义分割,每个分句精确对应音频时间戳,支持点击即跳转到音视频位置,打破传统文案的线性查看方式。
集成大语言模型生成分层级摘要,既能快速获取段落关键信息,也能完整掌握全文内容脉络。摘要自动入库,支持查看历史版本与迭代对比,支持强制重新生成自动覆盖,让内容分析全过程可追溯。
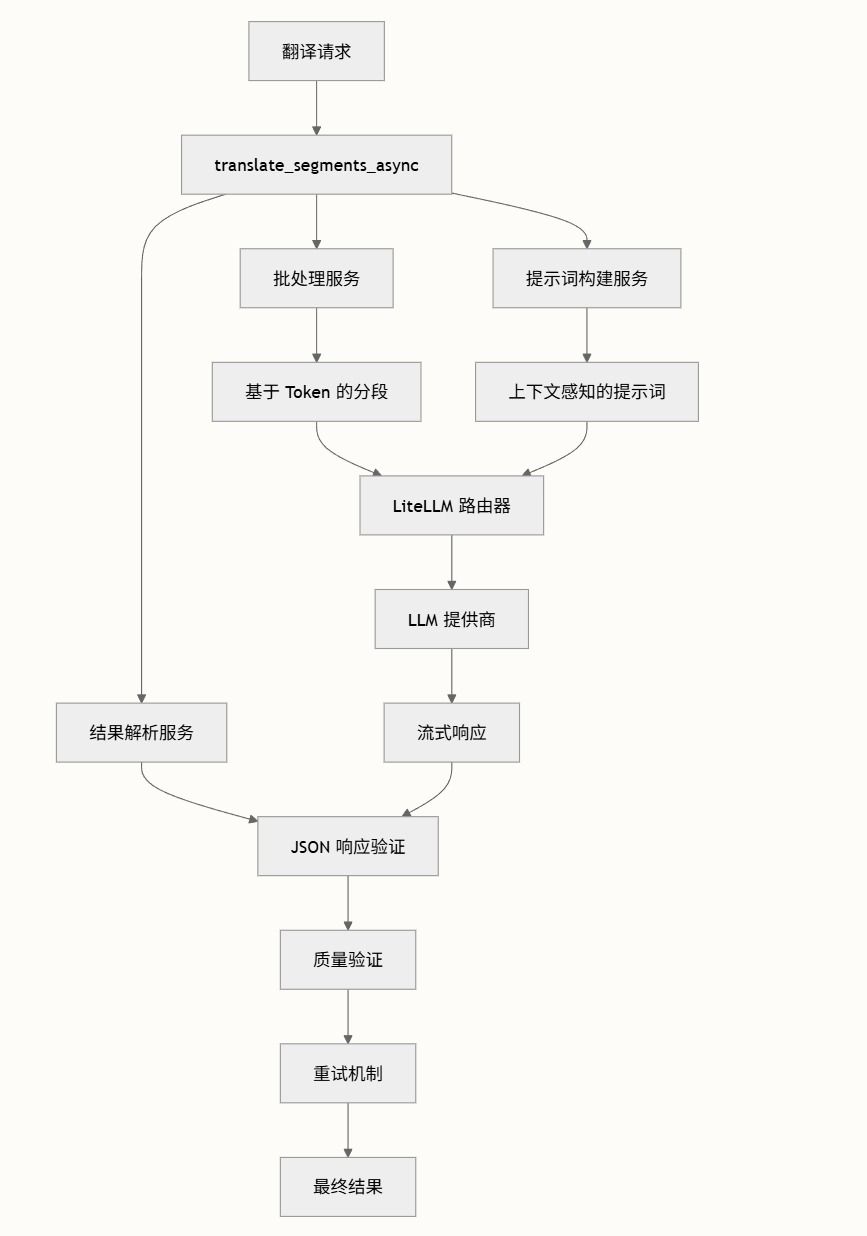
支持一键翻译为多种目标语言,后台异步处理不阻塞主流程,支持实时查看翻译进度。翻译结果完整持久化,多语言内容共存于一个项目中,轻松管理国际化内容。
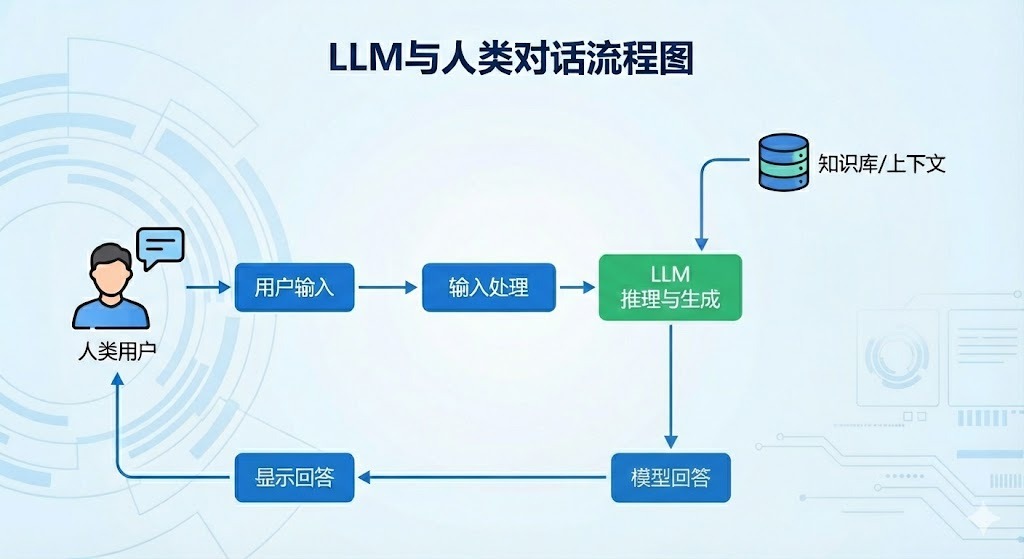
基于原始转写内容进行上下文感知的问答,支持单视频和多视频的综合分析。支持多轮追问与对话历史完整保留,系统能准确把握内容脉络,给出针对性的分析答案。
问答分两种模式,可在问答工具栏切换:
- 单轮检索(默认):服务端检索与问题最相关的转写片段,拼装带毫秒时间戳的上下文一次性生成答案;答案中的时间戳渲染为可点击跳转按钮。
- Agent 模式:为每个聊天会话启动一个独立的 agent 引擎子进程(隔离工作区,工具面收窄为四个领域 MCP 工具加技能激活),会话内多轮共用同一进程、由引擎自行保留上下文。引擎按领域协议自主检索(语义检索 → 片段精读 → 大纲),前端通过步骤帧实时展示「检索转写稿:…」这类过程。引擎启动失败时自动回落单轮模式,答案格式与时间戳跳转两种模式下一致。
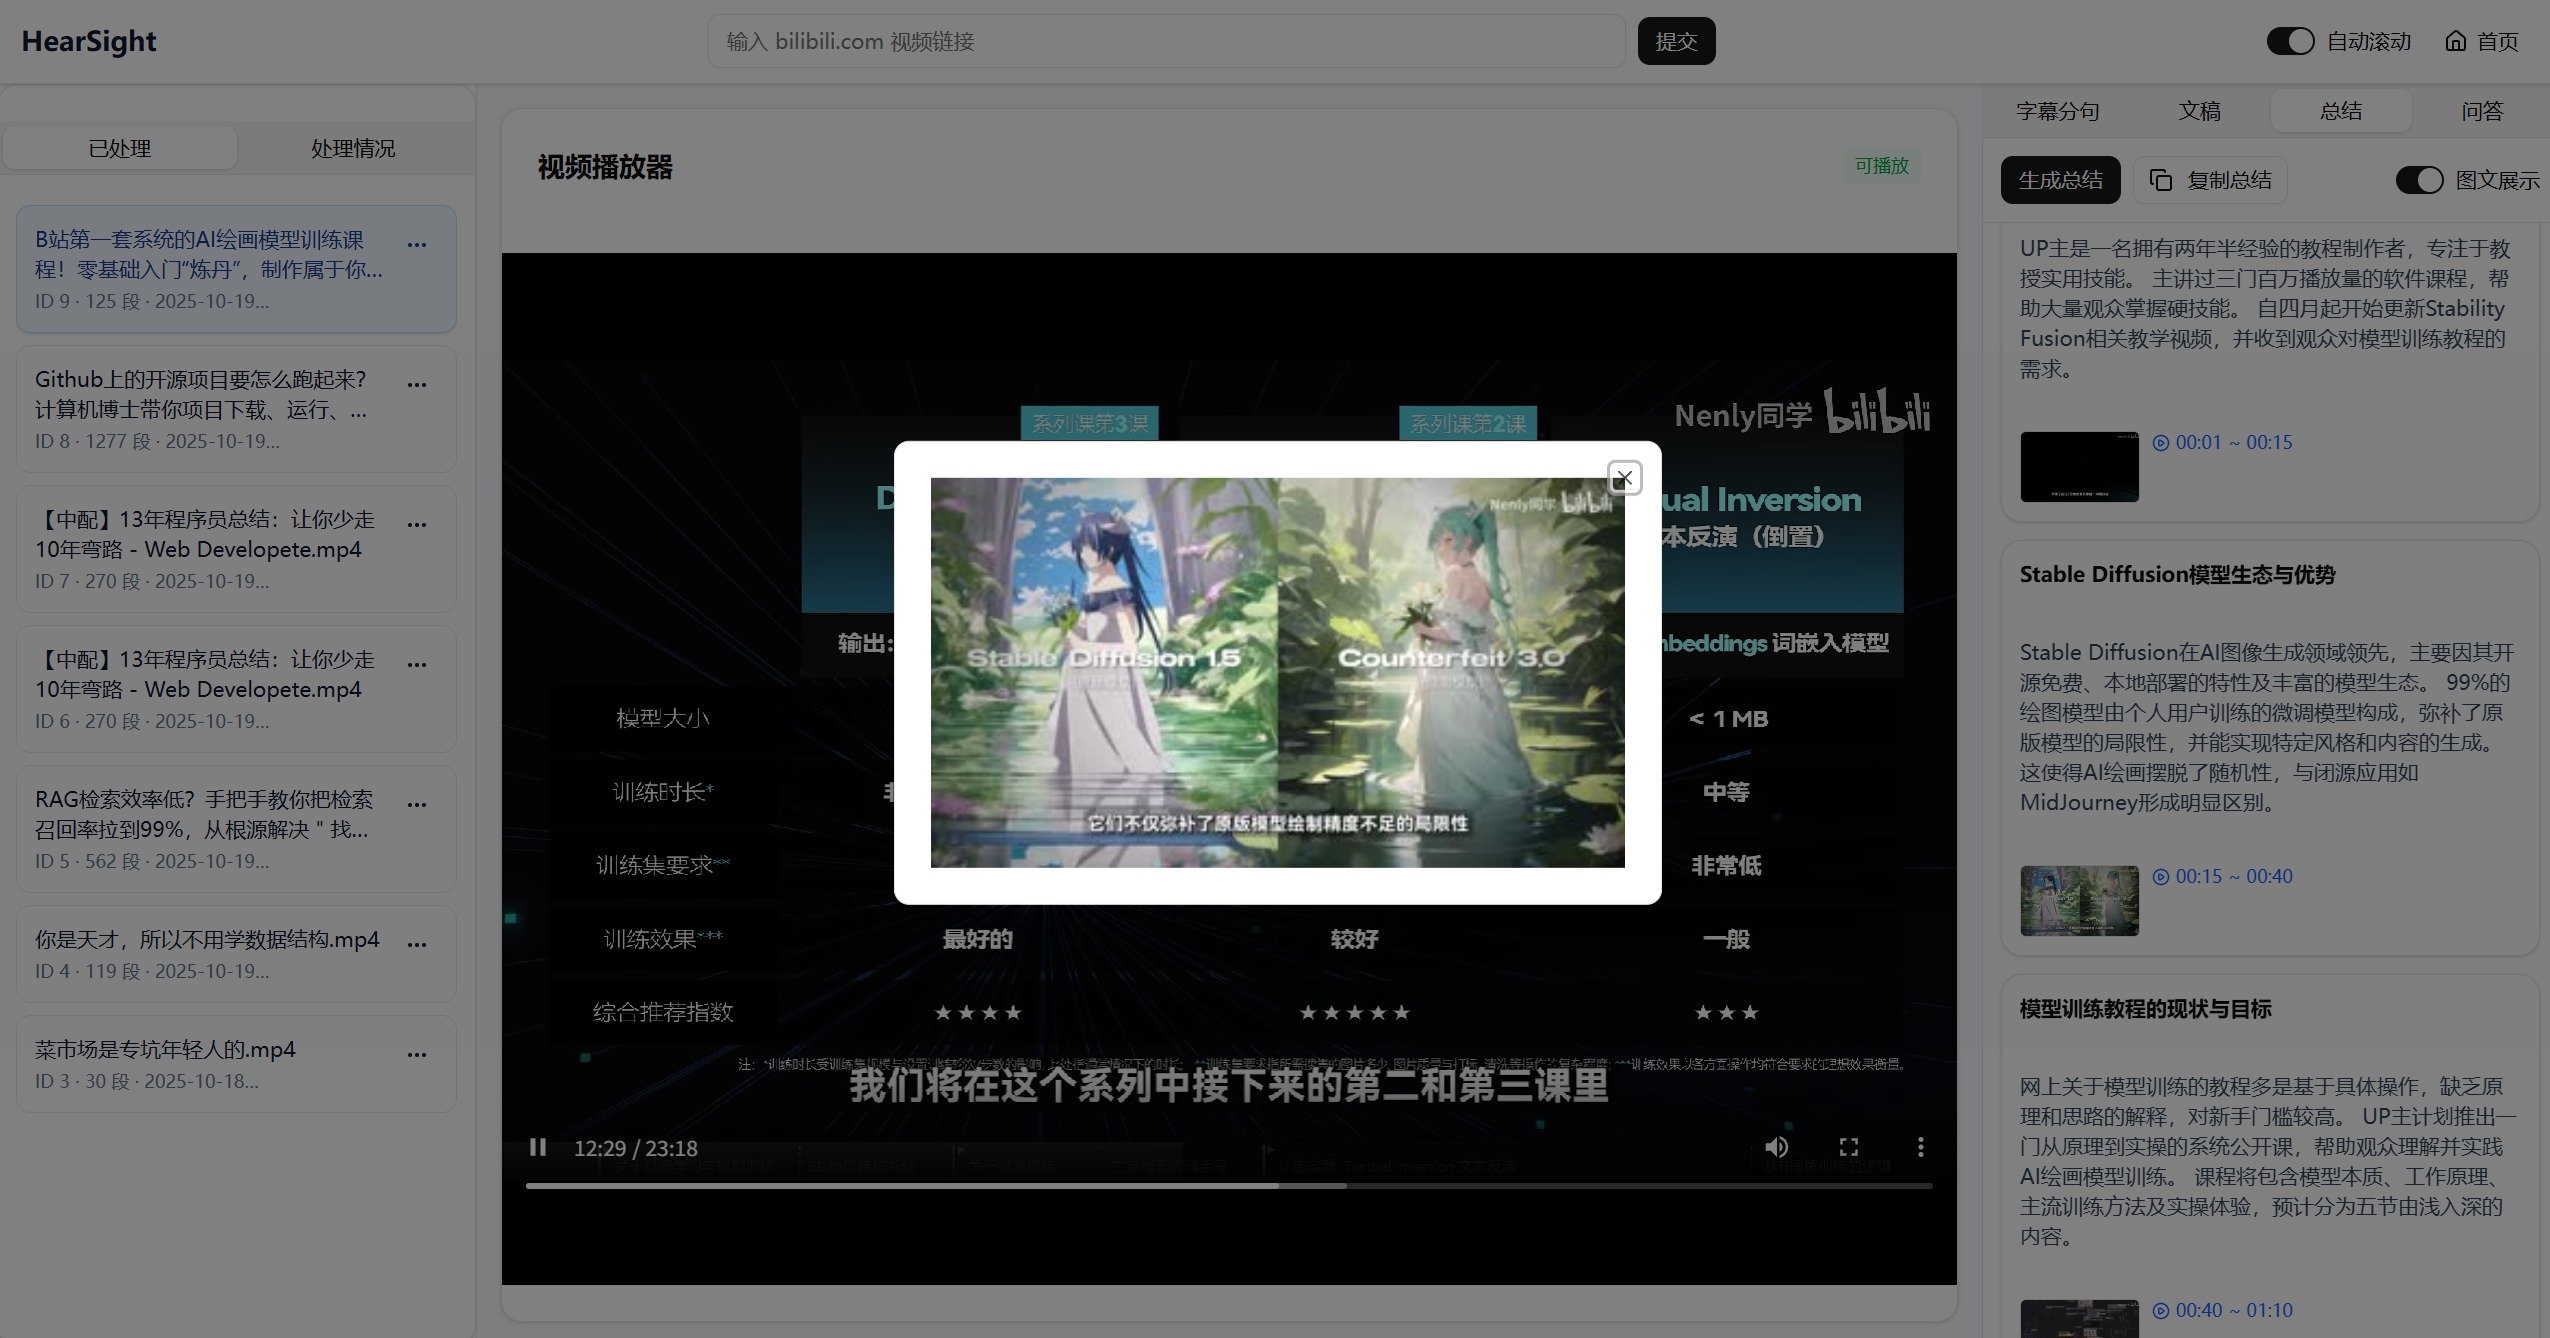
自动关联视频关键帧到摘要和问答结果中(仅适用于视频内容)。用户可点击查看大图,实现图文结合的直观表达,让复杂概念更容易理解。
HearSight 在实现过程中采用了许多的技术策略,以提升系统的性能和实际效果:
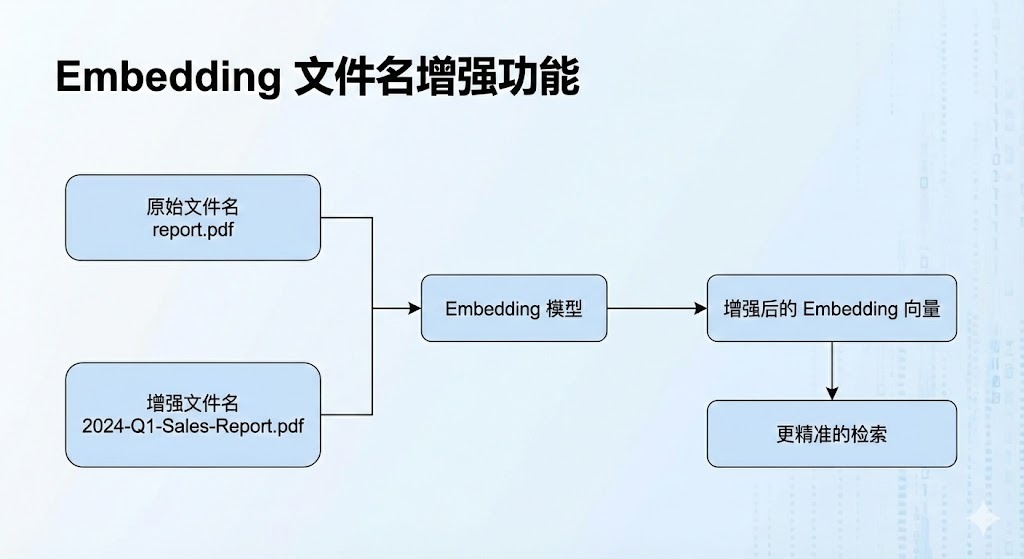
在知识库检索环节,我们实现了 embedding 文件名增强技术。通过在生成文本向量时,将文件名信息与内容文本相结合,形成更丰富的上下文嵌入。具体实现是在 chunk_text 前添加文件名描述,如 "文件名:[filename]\n内容:[text]",从而提升基于文件名提问的检索准确性。该策略有效解决了传统 embedding 仅基于内容而忽略文件名导致的检索不准问题,显著改善了用户查询体验,因为用户基于文件标题提问,很容易错漏相关文件,而给文件名一起进行embedding,会使得整个的效率,召回率平均能提升30%以上。
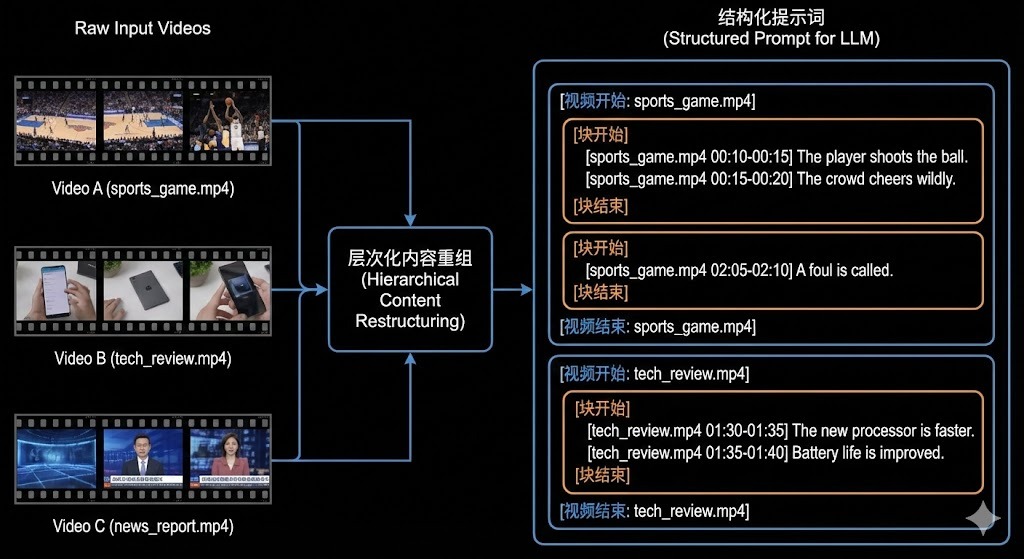
在多视频问答场景中,我们设计了层次化的检索内容重组结构,以确保不同视频和内容块有清晰的分界线。该结构采用嵌套标签系统:[视频开始/结束] 包围整个视频内容,[块开始/结束] 分隔连续的内容片段,每个句子附带精确的时间戳 [filename start-end]。这种设计避免了多视频内容混淆的问题,使大语言模型能够准确识别和引用特定视频段落,提升问答的精确性和可追溯性,同时保持提示词的结构化和可读性。
HearSight 是一个开源项目,我们欢迎来自社区的改进和贡献。无论是功能增强、bug 修复还是文档改进,都可以通过提交 Pull Request 的方式参与。如果有好的想法或发现问题,也可以直接提交 Issue。
本项目采用 Apache-2.0 License 开源许可证。详见 LICENSE 文件。